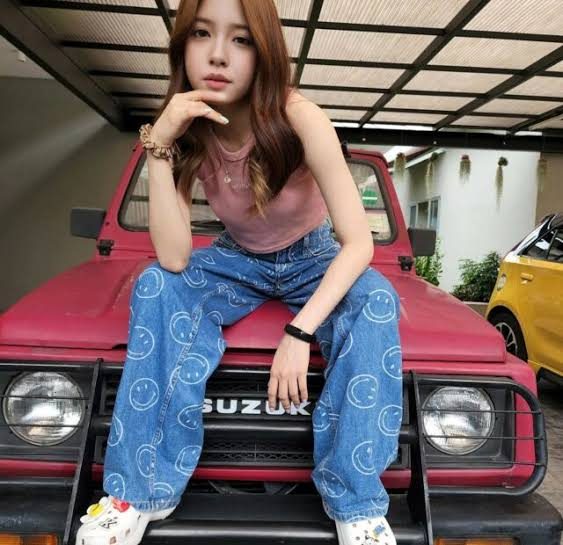
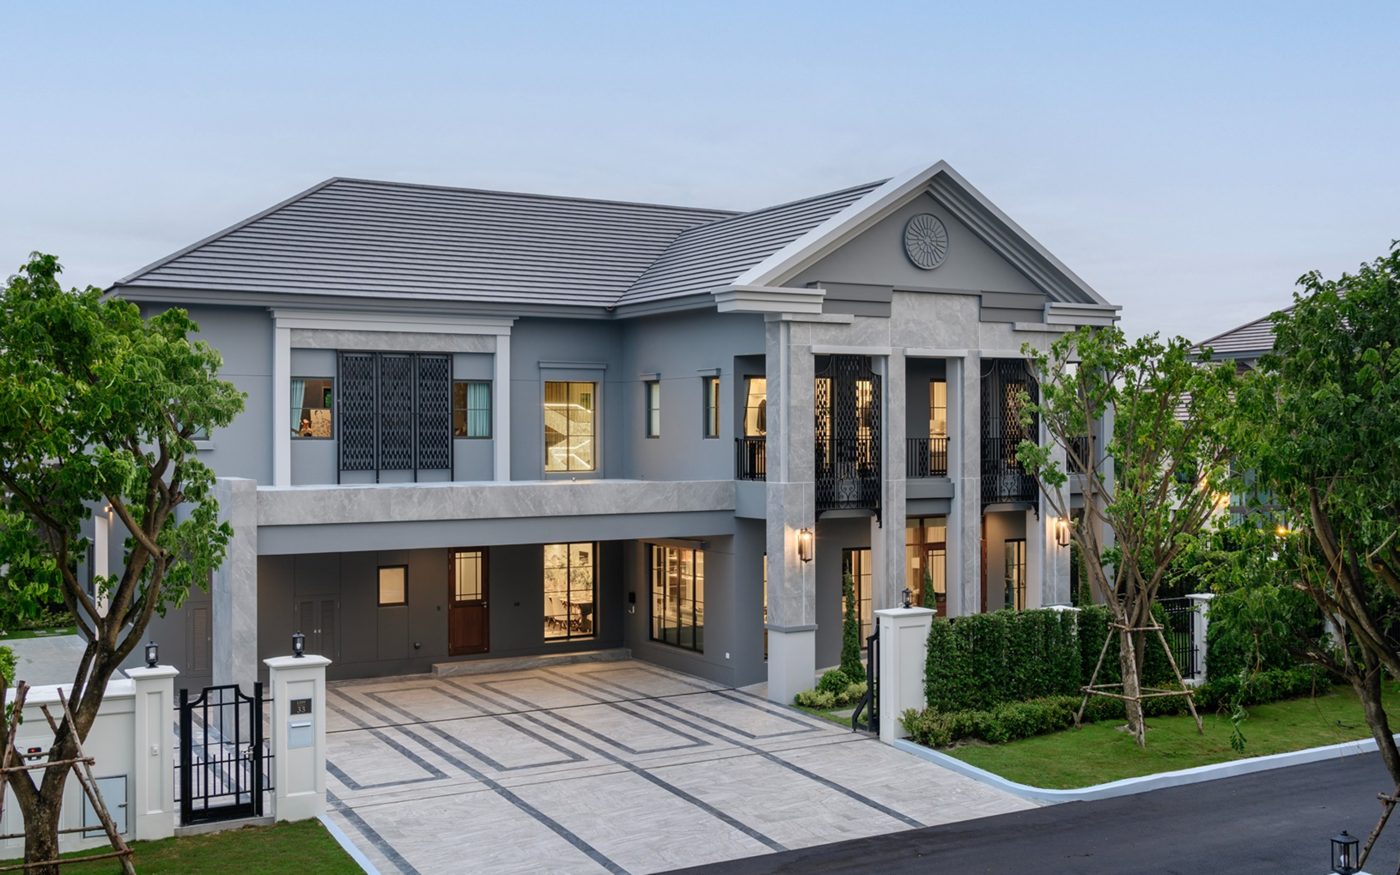
รูป 2 รูป คน + บ้าน · prompt UGC selfie แนวตั้ง พูดไทย lip sync (ดู prompt เต็ม) · บทพูด "สวัสดีค่ะ วันนี้พามาดูบ้านหลังนี้ค่ะ สองชั้น สไตล์คลาสสิก หน้าบ้านกว้างมาก จอดรถได้สองคันสบายๆ ใครสนใจทักมาได้เลยนะคะ"
ตารางให้คะแนน AI สร้างคลิปคนพูดภาษาไทย + ราคาต่อคลิป
ให้คะแนน 1–5 ทีละเกณฑ์ แล้วคูณน้ำหนัก = คะแนนเต็ม 100 · กดเลือกว่างานของคุณเน้นอะไร อันดับจะเรียงใหม่ทันที
| # | โมเดล | เสียง | ปาก | ภาพ | ตรงรูป | ราคา | ง่าย | credits คลิป 8 วิ | ยาวสุด | รวม |
|---|---|---|---|---|---|---|---|---|---|---|
| 1 | Gemini Omni Flash 1.1รูปอ้างอิง 2 รูป | 5 | 5 | 4 | 5 | 3.3 | 5 | 24 | 10 วิ | 91 |
| 2 | Gemini Omni Flashรูปอ้างอิง 2 รูป | 5 | 4 | 4 | 5 | 3.3 | 5 | 24 | 10 วิ | 88 |
| 3 | Google Veo 3.1ภาพตั้งต้น 1 รูป | 5 | 5 | 5 | 4 | 1 | 3 | 80 | 8 วิ | 83 |
| 4 | MiniMax H3รูปอ้างอิง 2 รูป | 4 | 4 | 2 | 5 | 5 | 5 | 16 | 15 วิ | 79 |
| 5 | Grok Video 1.5ภาพตั้งต้น 1 รูป | 4 | 4 | 3 | 3 | 2.2 | 3 | 36 | 15 วิ | 67 |
| 6 | Seedance 2.5รูปอ้างอิง 2 รูป | 1 | 4 | 4 | 5 | 1.4 | 5 | 56 | 30 วิ | 58 |
| 7 | Kling 3.0 proภาพตั้งต้น 1 รูป | 1 | 4 | 3 | 4 | 4 | 3 | 20 | 15 วิ | 57 |
| 8 | FLUX 3 Videoรูปอ้างอิง 2 รูป | 4 | 1 | 1 | 1 | 1.8 | 5 | 44 | 20 วิ | 44 |
ราคาบาทคิดจากแพ็กเกจ Higgsfield $39 = 1.29 บาท/เครดิต (แพ็กเกจ $15 = 2.50 · $99 = 1.09) — เปลี่ยนแพ็กเกจ ราคาต่อคลิปเปลี่ยนตาม
ผลทดสอบ AI สร้างวิดีโอพูดไทย ดูคลิปจริงทีละตัว
เรียงตามคะแนนแบบสมดุล · ทุกตัวสร้างใหม่จากรูปชุดเดียวกัน
โมเดลที่รับได้แค่รูปเดียว (Veo · Kling · Grok) ใช้เฟรมแรกของคลิปอันดับ 1 เป็นภาพตั้งต้น เพื่อให้คนและบ้านเหมือนกันทุกตัว · เครื่องมือแก้คลิปเดิม (Genjutsu · Extend · Viral preset) แยกไว้ในหัวข้อถัดไป เพราะเป็นคนละโจทย์
แก้คลิปเดิม: เปลี่ยนคน เปลี่ยนเสื้อ ต่อคลิป เปลี่ยนชุด
ไม่ใช่โมเดลสร้างคลิปจากรูป แต่เอาคลิปที่มีอยู่แล้วมาแก้ — คนละโจทย์กับตารางคะแนน เลยแยกไว้ตรงนี้ · ทดสอบ 22–23 ก.ย. 2569 · คนในคลิปสร้างด้วย AI ไม่ใช่คนจริง
| Genjutsu · Motion Control | Genjutsu · Replace Object | |
|---|---|---|
| สรุปสั้นๆ | คนในรูป ขยับตามท่าในคลิป | คลิปเดิม เปลี่ยนแค่บางอย่าง |
| ใส่อะไร | คลิปต้นแบบท่าทาง + รูปคน | คลิปต้นแบบ + รูปของที่จะใส่แทน (เสื้อ · สินค้า · คน) |
| ฉากกับแสง | มาจากรูป — เปลี่ยนตามรูปที่ใส่ | เหมือนคลิปเดิมทุกอย่าง |
| เหมาะกับ | ให้คนใหม่ทำท่าเดิมในฉากใหม่ · มาสคอตเต้นท่าเทรนด์ · ทำรูปนิ่งให้ขยับ | คลิปเดียวใช้ได้หลายสินค้า หลายสี หลายพรีเซนเตอร์ · ฉากต้องเหมือนเดิม |
| ไม่เหมาะกับ | เปลี่ยนแค่คนแต่อยากได้ฉากเดิม | อยากได้ท่าทางหรือฉากใหม่ |
| เครดิต | 56 | 63 |
เลือก AI สร้างวิดีโอยังไงให้คุ้ม
คำถามที่พบบ่อย: AI สร้างวิดีโอตัวไหนดี
โมเดล AI สร้างวิดีโอตัวไหนพูดภาษาไทยได้ชัดที่สุด
จากการให้คะแนน 8 โมเดลด้วยโจทย์เดียวกัน Gemini Omni Flash 1.1 ให้เสียงไทยชัด ปากตรง และภาพ smooth ที่สุด ในราคา 24 credits ต่อคลิป 8 วินาที รองลงมาคือ Gemini Omni Flash รุ่นเดิม ส่วน Kling 3.0 พูดไทยออกมาเป็นสำเนียงเขมร และ Seedance 2.5 เพี้ยนแบบชาวต่างชาติพูดไทย
Google Veo 3.1 พูดไทยได้ไหม
ได้ และทำได้ดี — เสียงไทยชัดมาก ภาพชัดแสงสวยแบบภาพยนตร์ ท่าทางเป็นธรรมชาติ ผ่านการทดสอบ แต่เป็นโมเดลที่แพงที่สุด (80 credits) แพงกว่า Gemini Omni Flash 1.1 ประมาณ 3.3 เท่า และรับรูปอ้างอิงได้แค่รูปเดียว ต้องทำภาพตั้งต้นก่อน · เหมาะกับงานที่อยากได้ภาพระดับโฆษณา
ฟีเจอร์ Extend ต่อความยาววิดีโอ AI ใช้ได้ไหม
ต่อภาพได้ แต่เสียงถูกสร้างใหม่ทุกครั้ง ทำให้เสียงและสำเนียงเปลี่ยน วิธีที่ใช้ได้คือเจนหลายคลิปสั้นจากรูปอ้างอิงชุดเดิมและโมเดลเดิม แล้วนำมาตัดต่อ
ถ้ามีคลิปที่ดีแล้ว เปลี่ยนพรีเซนเตอร์เป็นคนอื่นได้ไหม
ได้ ด้วย motion transfer เช่น Genjutsu ของ Higgsfield (56 credits) ซึ่งคงท่าทางเดิม เปลี่ยนเป็นคนใหม่ได้จริง (ฉากกับโทนสีอาจเปลี่ยนตาม) หรือ Genjutsu Replace Object (63 credits) ที่คงฉากเดิมทุกอย่าง